OCR für gescannte PDFs
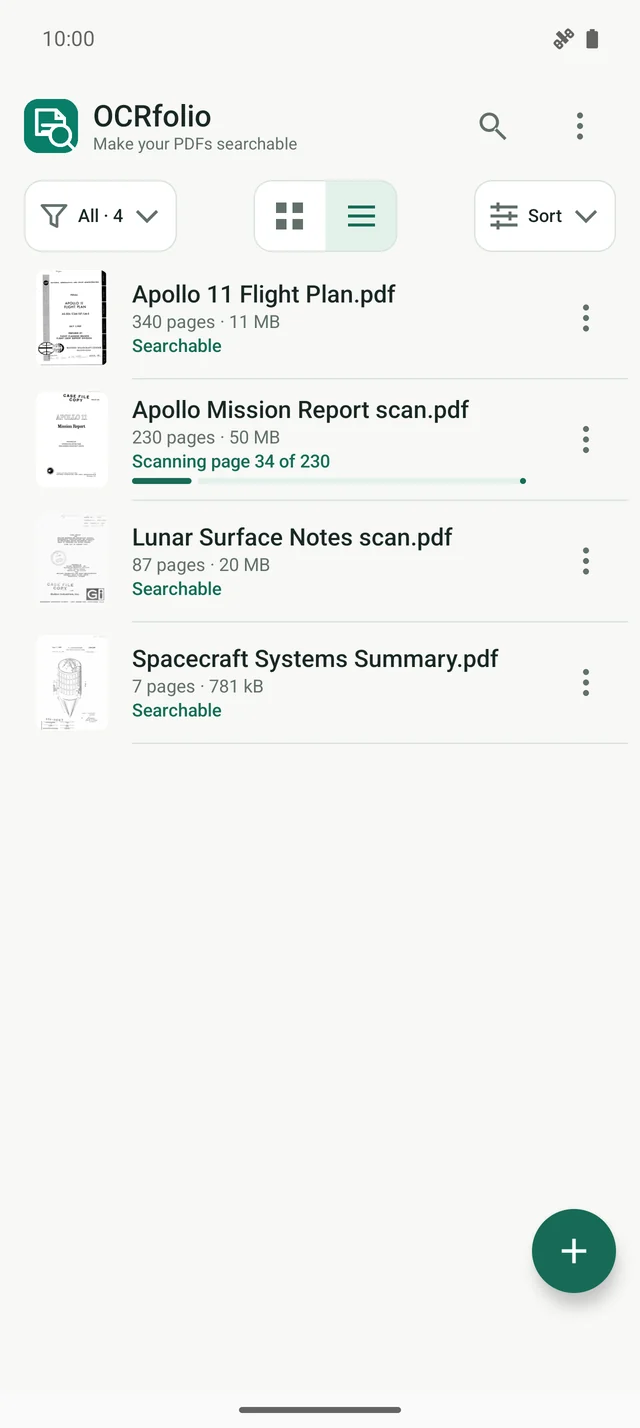
PDFs ohne verwendbaren Text werden nach dem Import für die OCR auf dem Gerät in die Warteschlange gestellt. Verfolgen Sie den Seitenfortschritt und die geschätzte verbleibende Zeit, während die Verarbeitung im Hintergrund fortgesetzt wird. PDFs mit verwendbarem eingebettetem Text werden ohne OCR indiziert. Die Suche wird verfügbar, sobald der Text indiziert wird.
Ihr Original bleibt unverändert
Arbeiten Sie mit PDFs von bis zu 999 Seiten. Die Bibliothek behält Ihr Original unverändert und fügt eine separate, durchsuchbare Kopie hinzu. Exportieren Sie eine Kopie mit dem Android-Speicherdialog an einen beliebigen Ort.
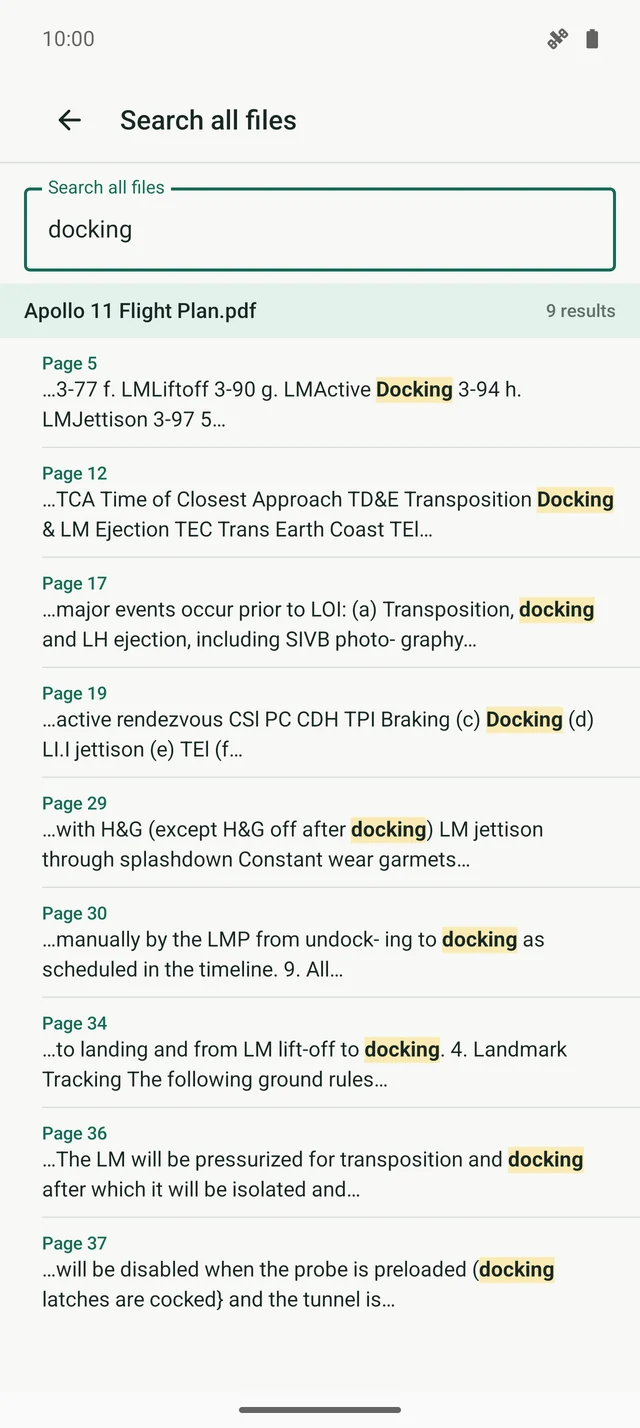
Finden Sie erkannten Text in allen Dokumenten
Durchsuchen Sie die in Ihrer Bibliothek indizierten PDFs. Übereinstimmende Seiten werden nach Datei gruppiert. Öffnen Sie ein Ergebnis auf seiner Seite und sehen Sie, wie passende Wörter hervorgehoben werden.
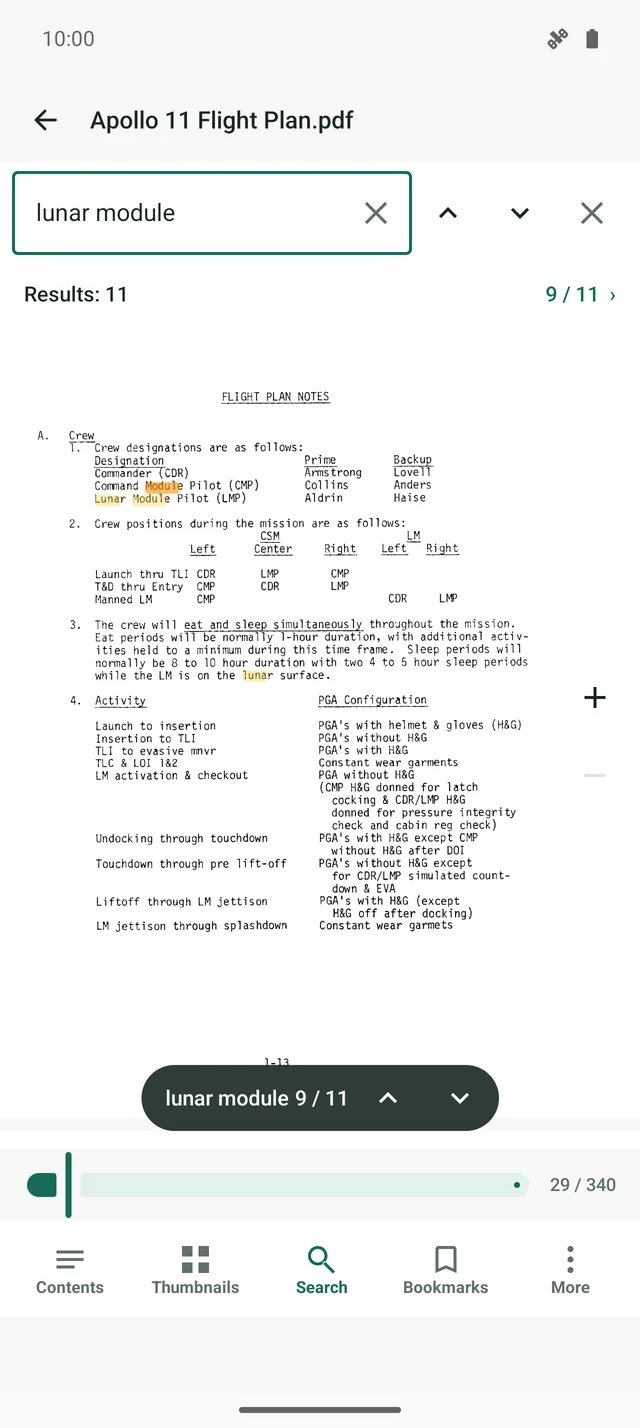
Auswählen, kopieren und lesen
Inhalt, Miniaturansichten, Lesezeichen und Gehe zu Seite. Markieren Sie Text mit den Anfassern und kopieren Sie ihn. Wählen Sie Einzelseite, Doppelseite oder fortlaufendes Scrollen, mit dunklem Design.
Eine Bibliothek für Ihre PDFs
Halten Sie importierte PDFs und ihre durchsuchbaren Kopien zusammen. Organisieren Sie sie in Ordnern, wählen Sie mehrere Dateien gleichzeitig aus und ziehen Sie sie an die gewünschte Stelle.
Dokumente bleiben auf Ihrem Gerät
Die Erkennung nutzt Modelle in der App. Es gibt kein Konto, und Ihre PDFs und deren Text werden an keinen Server gesendet.
 OCRfolio