OCR pour les PDF numérisés
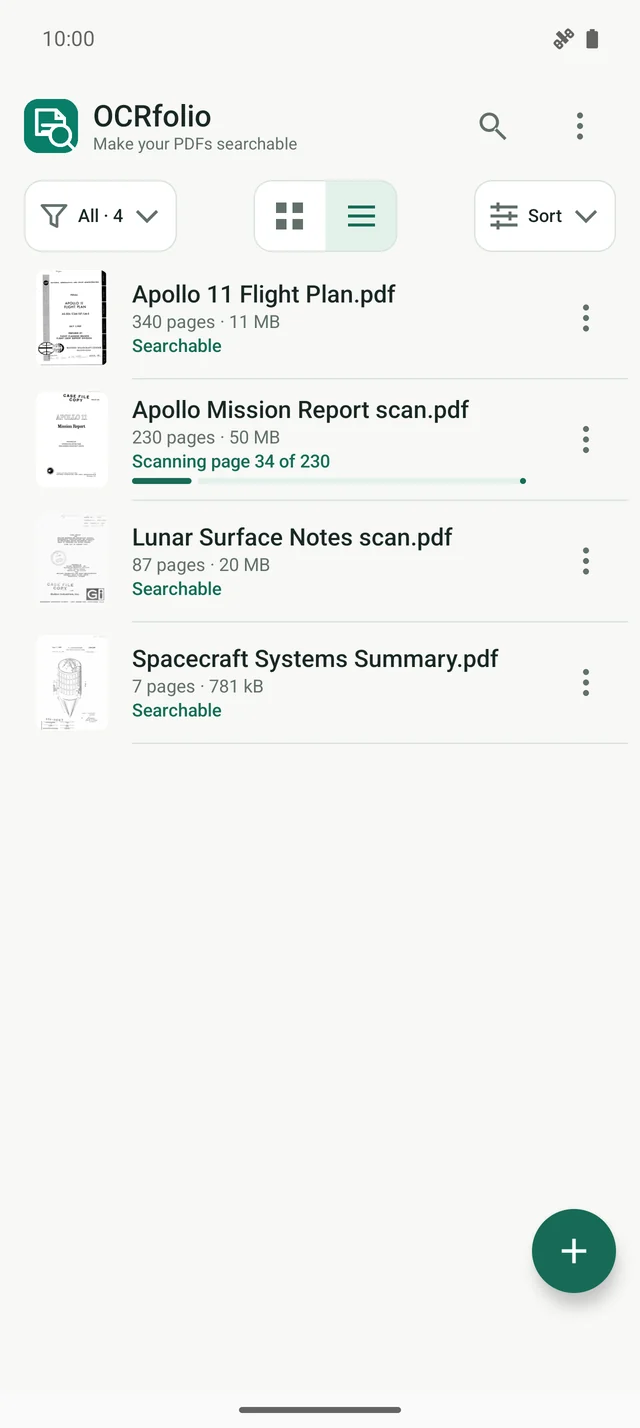
Les PDF sans texte utilisable sont mis en file d'attente pour l'OCR sur l'appareil après l'importation. Suivez la progression de la page et le temps restant estimé pendant que le traitement se poursuit en arrière-plan. Les PDF contenant du texte incorporé utilisable sont indexés sans OCR. La recherche devient disponible à mesure que leur texte est indexé.
Votre original reste inchangé
Travaillez avec des PDF allant jusqu'à 999 pages. La bibliothèque garde votre original tel quel et ajoute une copie distincte où l'on peut faire des recherches. Exportez une copie où vous voulez avec la boîte de dialogue d'enregistrement d'Android.
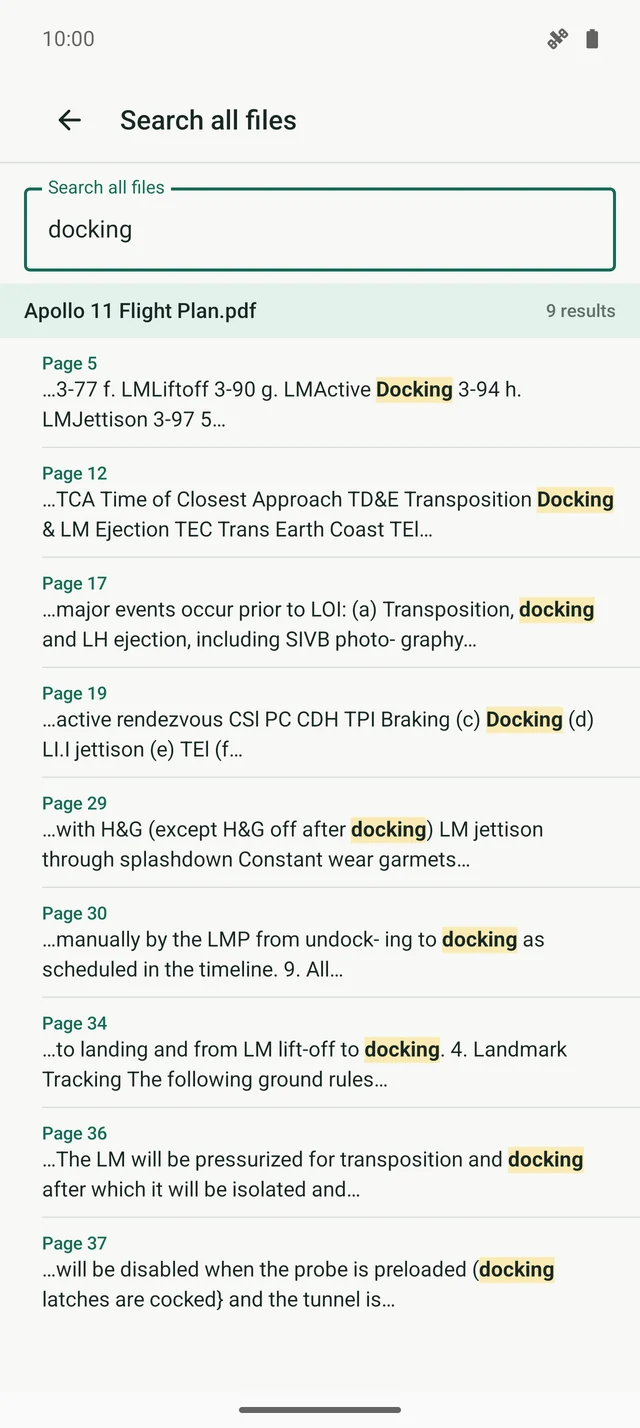
Rechercher du texte reconnu dans les documents
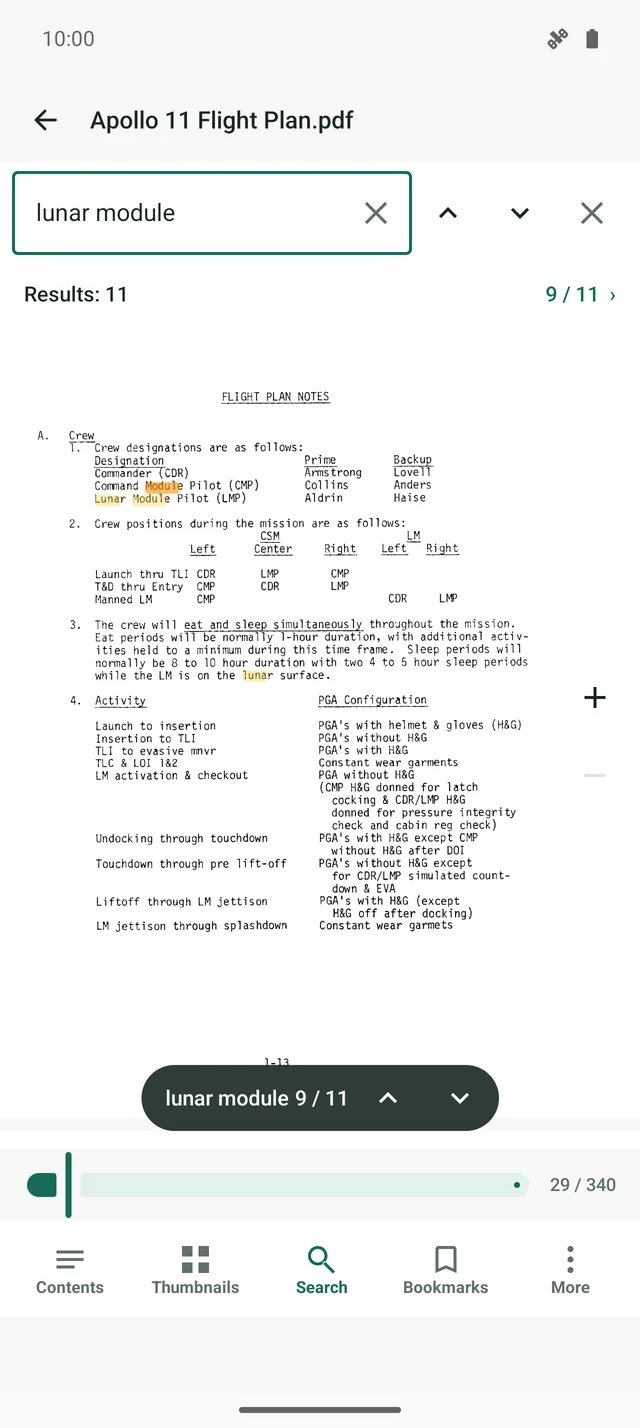
Recherchez les PDF indexés dans votre bibliothèque. Les pages correspondantes sont regroupées par fichier. Ouvrez un résultat sur sa page et voyez les mots correspondants mis en surbrillance.
Sélectionner, copier et lire
Sommaire, miniatures, signets et accès à une page. Sélectionnez du texte avec les poignées et copiez-le. Choisissez une page, deux pages ou le défilement continu, avec un thème sombre.
Une bibliothèque pour vos PDF
Conservez ensemble les PDF importés et leurs copies consultables. Organisez-les dans des dossiers, sélectionnez plusieurs fichiers à la fois et faites-les glisser là où vous le souhaitez.
Les documents restent sur votre appareil
La reconnaissance utilise des modèles intégrés à l'application. Il n'y a pas de compte, et vos PDF et leur texte ne sont envoyés à aucun serveur.
 OCRfolio