OCR para archivos PDF escaneados
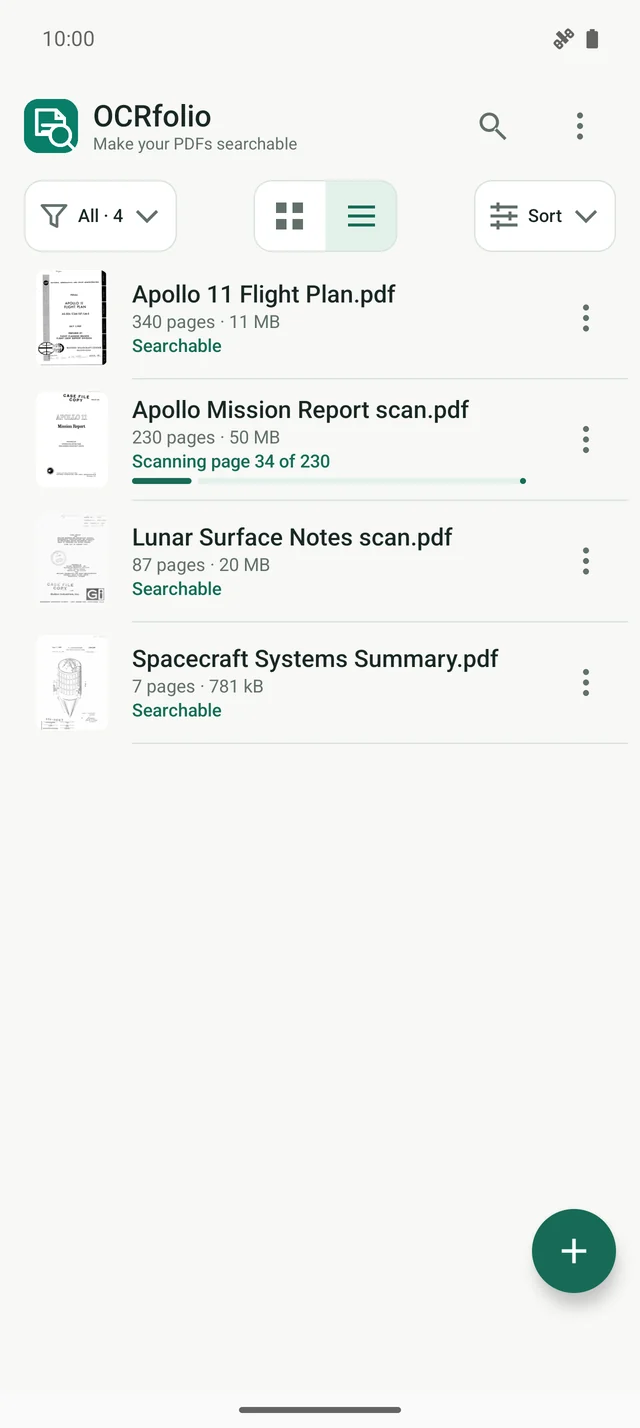
Los archivos PDF sin texto utilizable se ponen en cola para OCR en el dispositivo después de la importación. Siga el progreso de la página y el tiempo restante estimado mientras el procesamiento continúa en segundo plano. Los archivos PDF con texto incrustado utilizable se indexan sin OCR. La búsqueda estará disponible a medida que se indexe su texto.
Tu original permanece sin cambios.
Trabaja con PDF de hasta 999 páginas. La biblioteca conserva tu original tal cual y añade una copia aparte en la que se puede buscar. Exporta una copia donde quieras con el cuadro de diálogo de guardado de Android.
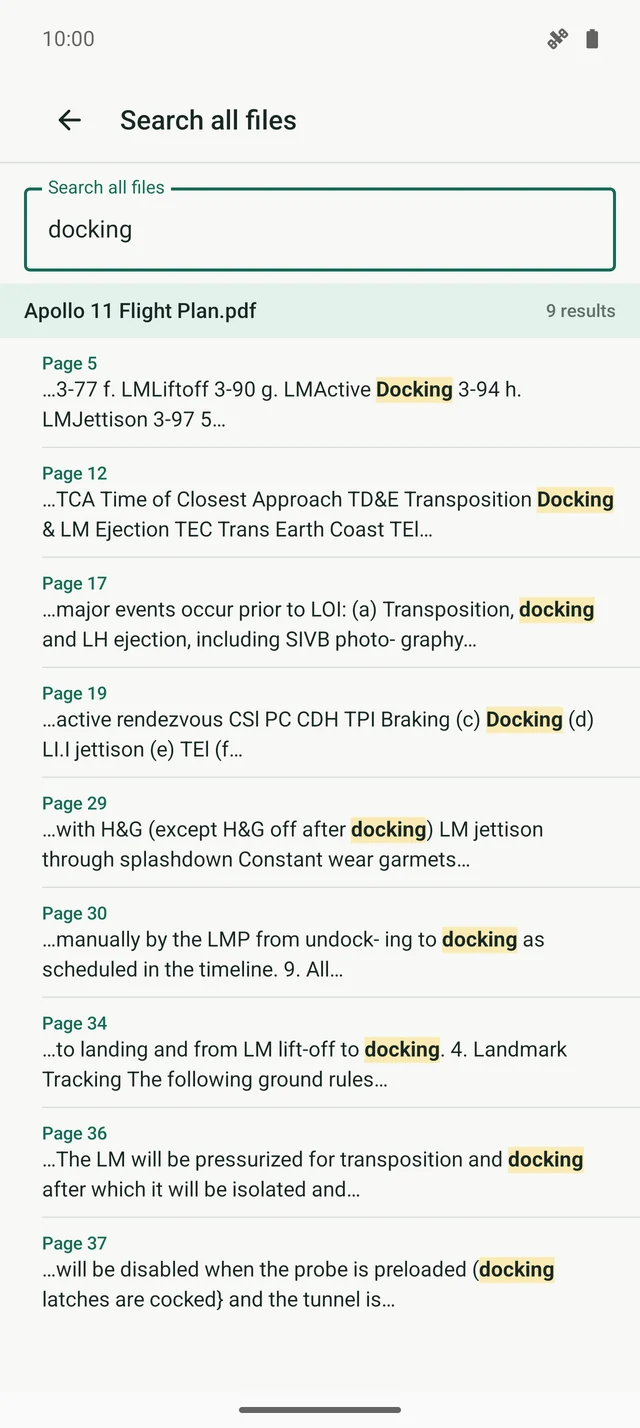
Encuentre texto reconocido en todos los documentos
Busque los archivos PDF indexados en su biblioteca. Las páginas coincidentes se agrupan por archivo. Abra un resultado en su página y vea las palabras coincidentes resaltadas.
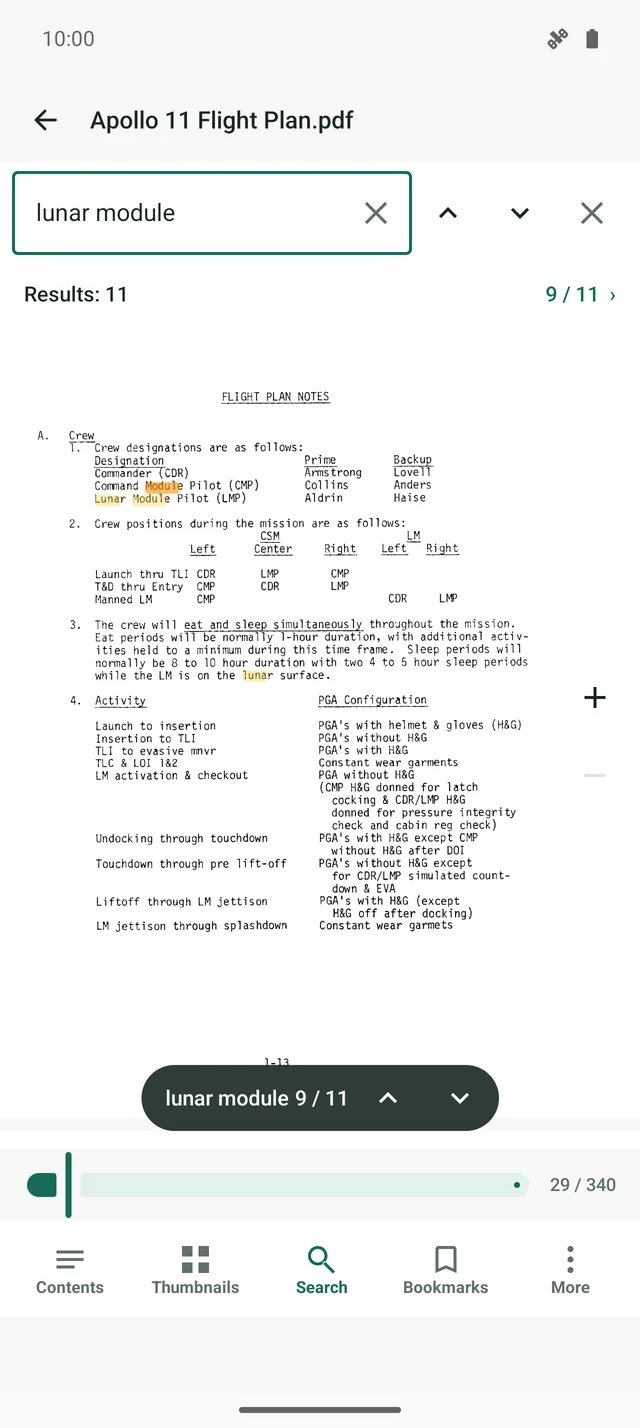
Seleccionar, copiar y leer
Índice, miniaturas, marcadores e ir a una página. Selecciona texto con los controles y cópialo. Elige una página, dos páginas o desplazamiento continuo, con tema oscuro.
Una biblioteca para tus archivos PDF
Mantenga juntos los archivos PDF importados y sus copias con capacidad de búsqueda. Organízalos en carpetas, selecciona varios archivos a la vez y arrástralos a donde quieras.
Los documentos permanecen en su dispositivo
El reconocimiento usa modelos incluidos en la aplicación. No hay cuenta, y tus PDF y su texto no se envían a ningún servidor.
 OCRfolio