スキャンした PDF の OCR
使用可能なテキストのない PDF は、インポート後にオンデバイス OCR のキューに入れられます。バックグラウンドで処理が続行されている間、ページの進行状況と推定残り時間を追跡します。使用可能な埋め込みテキストを含む PDF は、OCR なしでインデックス付けされます。テキストがインデックス化されると、検索が可能になります。
スキャンPDFを検索可能にし、文字を選択・コピーできるようにします。OCRfolioはAndroid端末内でスキャン文書の文字を認識し、元のPDFを変えずに、別のPDFに見えないテキストレイヤーを追加します。PDFやその文字はアップロードされません。
スキャンした PDF を追加し、OCR でページを認識させ、認識されたテキストを検索するか、選択してコピーします。結果をライブラリに保存したり、インデックス付きドキュメント間で一致するページを検索したり、検索可能な PDF をエクスポートしたりできます。新しいスキャンを開始するには、広告とインターネット接続が必要です。
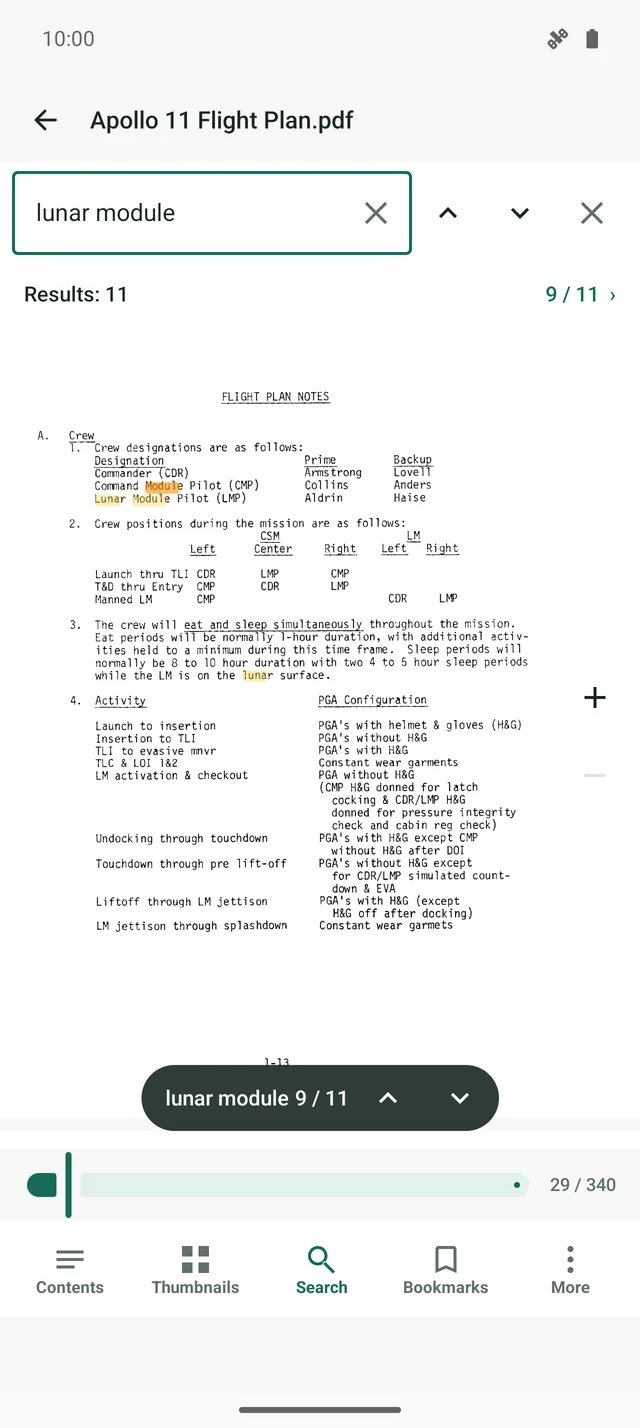
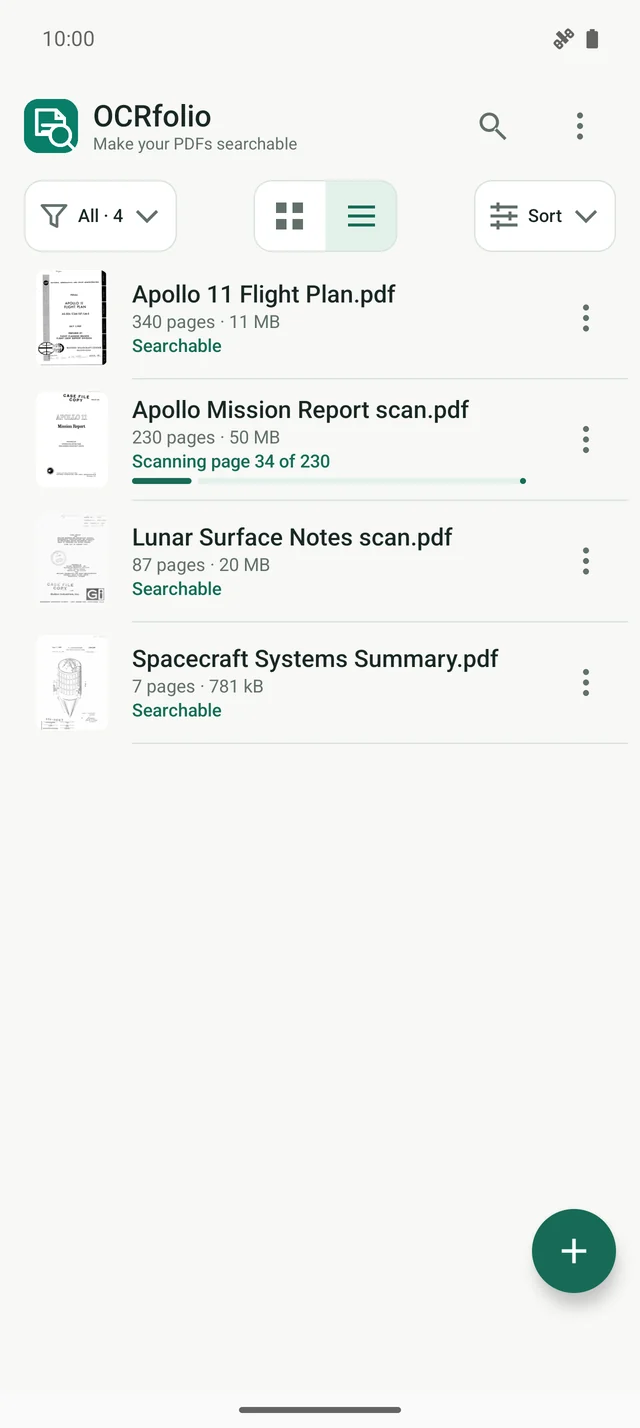
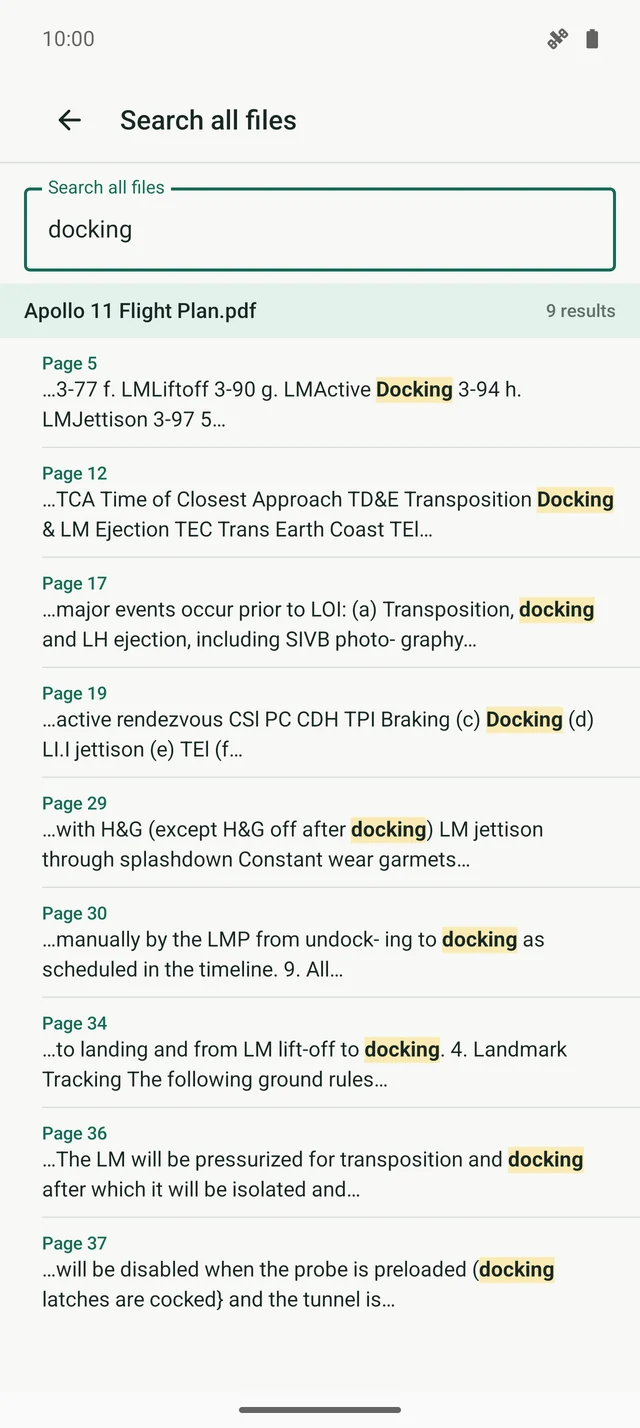
使用可能なテキストのない PDF は、インポート後にオンデバイス OCR のキューに入れられます。バックグラウンドで処理が続行されている間、ページの進行状況と推定残り時間を追跡します。使用可能な埋め込みテキストを含む PDF は、OCR なしでインデックス付けされます。テキストがインデックス化されると、検索が可能になります。
最大999ページのPDFを扱えます。ライブラリは元のファイルをそのまま保ち、検索できるコピーを別に追加します。コピーはAndroidの保存ダイアログから好きな場所へ書き出せます。
ライブラリ内でインデックス付けされた PDF を検索します。一致するページはファイルごとにグループ化されます。結果のページを開くと、一致する単語が強調表示されます。
目次、サムネイル、しおり、ページ指定ジャンプ。ハンドルでテキストを選択してコピーできます。単一ページ、見開き(2ページ)、連続スクロールから選べ、ダークテーマにも対応します。
インポートした PDF とその検索可能なコピーを一緒に保管します。ファイルをフォルダーに整理し、複数のファイルを一度に選択して、目的の場所にドラッグします。
認識にはアプリ内のモデルを使用します。アカウントは不要で、PDFとそのテキストがサーバーに送信されることはありません。
使用可能なテキストのない PDF は、インポート後にオンデバイス OCR のキューに入れられます。バックグラウンドで処理が続行されている間、ページの進行状況と推定残り時間を追跡します。使用可能な埋め込みテキストを含む PDF は、OCR なしでインデックス付けされます。テキストがインデックス化されると、検索が可能になります。
最大999ページのPDFを扱えます。ライブラリは元のファイルをそのまま保ち、検索できるコピーを別に追加します。コピーはAndroidの保存ダイアログから好きな場所へ書き出せます。
ライブラリ内でインデックス付けされた PDF を検索します。一致するページはファイルごとにグループ化されます。結果のページを開くと、一致する単語が強調表示されます。
目次、サムネイル、しおり、ページ指定ジャンプ。ハンドルでテキストを選択してコピーできます。単一ページ、見開き(2ページ)、連続スクロールから選べ、ダークテーマにも対応します。
認識にはアプリ内のモデルを使用します。アカウントは不要で、PDFとそのテキストがサーバーに送信されることはありません。アプリはドキュメントの内容を含まない利用統計(Google Analytics)を送信します。設定の「ストレージとプライバシー」でオフにできます。詳しくはプライバシーポリシーをご覧ください。
OCRfolio は広告によってサポートされています。新しいスキャンが開始される前に広告が表示されるため、スキャンを開始するにはインターネット接続が必要です。ライブラリにすでにインデックスが作成されている PDF の読み取りと検索は、オフラインでも機能します。
最大999ページのPDFを扱えます。ライブラリは元のファイルをそのまま保ち、検索できるコピーを別に追加します。コピーはAndroidの保存ダイアログから好きな場所へ書き出せます。
結果はスキャンの状態によって変わります。鮮明でまっすぐな印刷ページは認識に向いています。手書き、非常に古いページやコントラストの低いページ、複雑なレイアウトは、結果が不完全だったり順序が乱れたりすることがあります。
パスワード保護されたPDFはライブラリに残りますが、まだスキャンできません。